Cadence 发布 Maestro 专... - 游戏买量
2026年10月26日,Cadence(楷登电子)正式发布 Maestro 专用 AI 模型系列,面向芯片设计代理场景做了深度微调。据 Tom's Hardware 报道,与通用大模型相比,Maestro 在芯片设计任务中可带来最高 30% 的结果质量提升,并将 Token 效率提高至 5 倍。早期访问定于 2026 年第四季度向“精选客户”开放。
最新新闻芯片设计进入“代理式 AI”时代:Maestro 是什么?
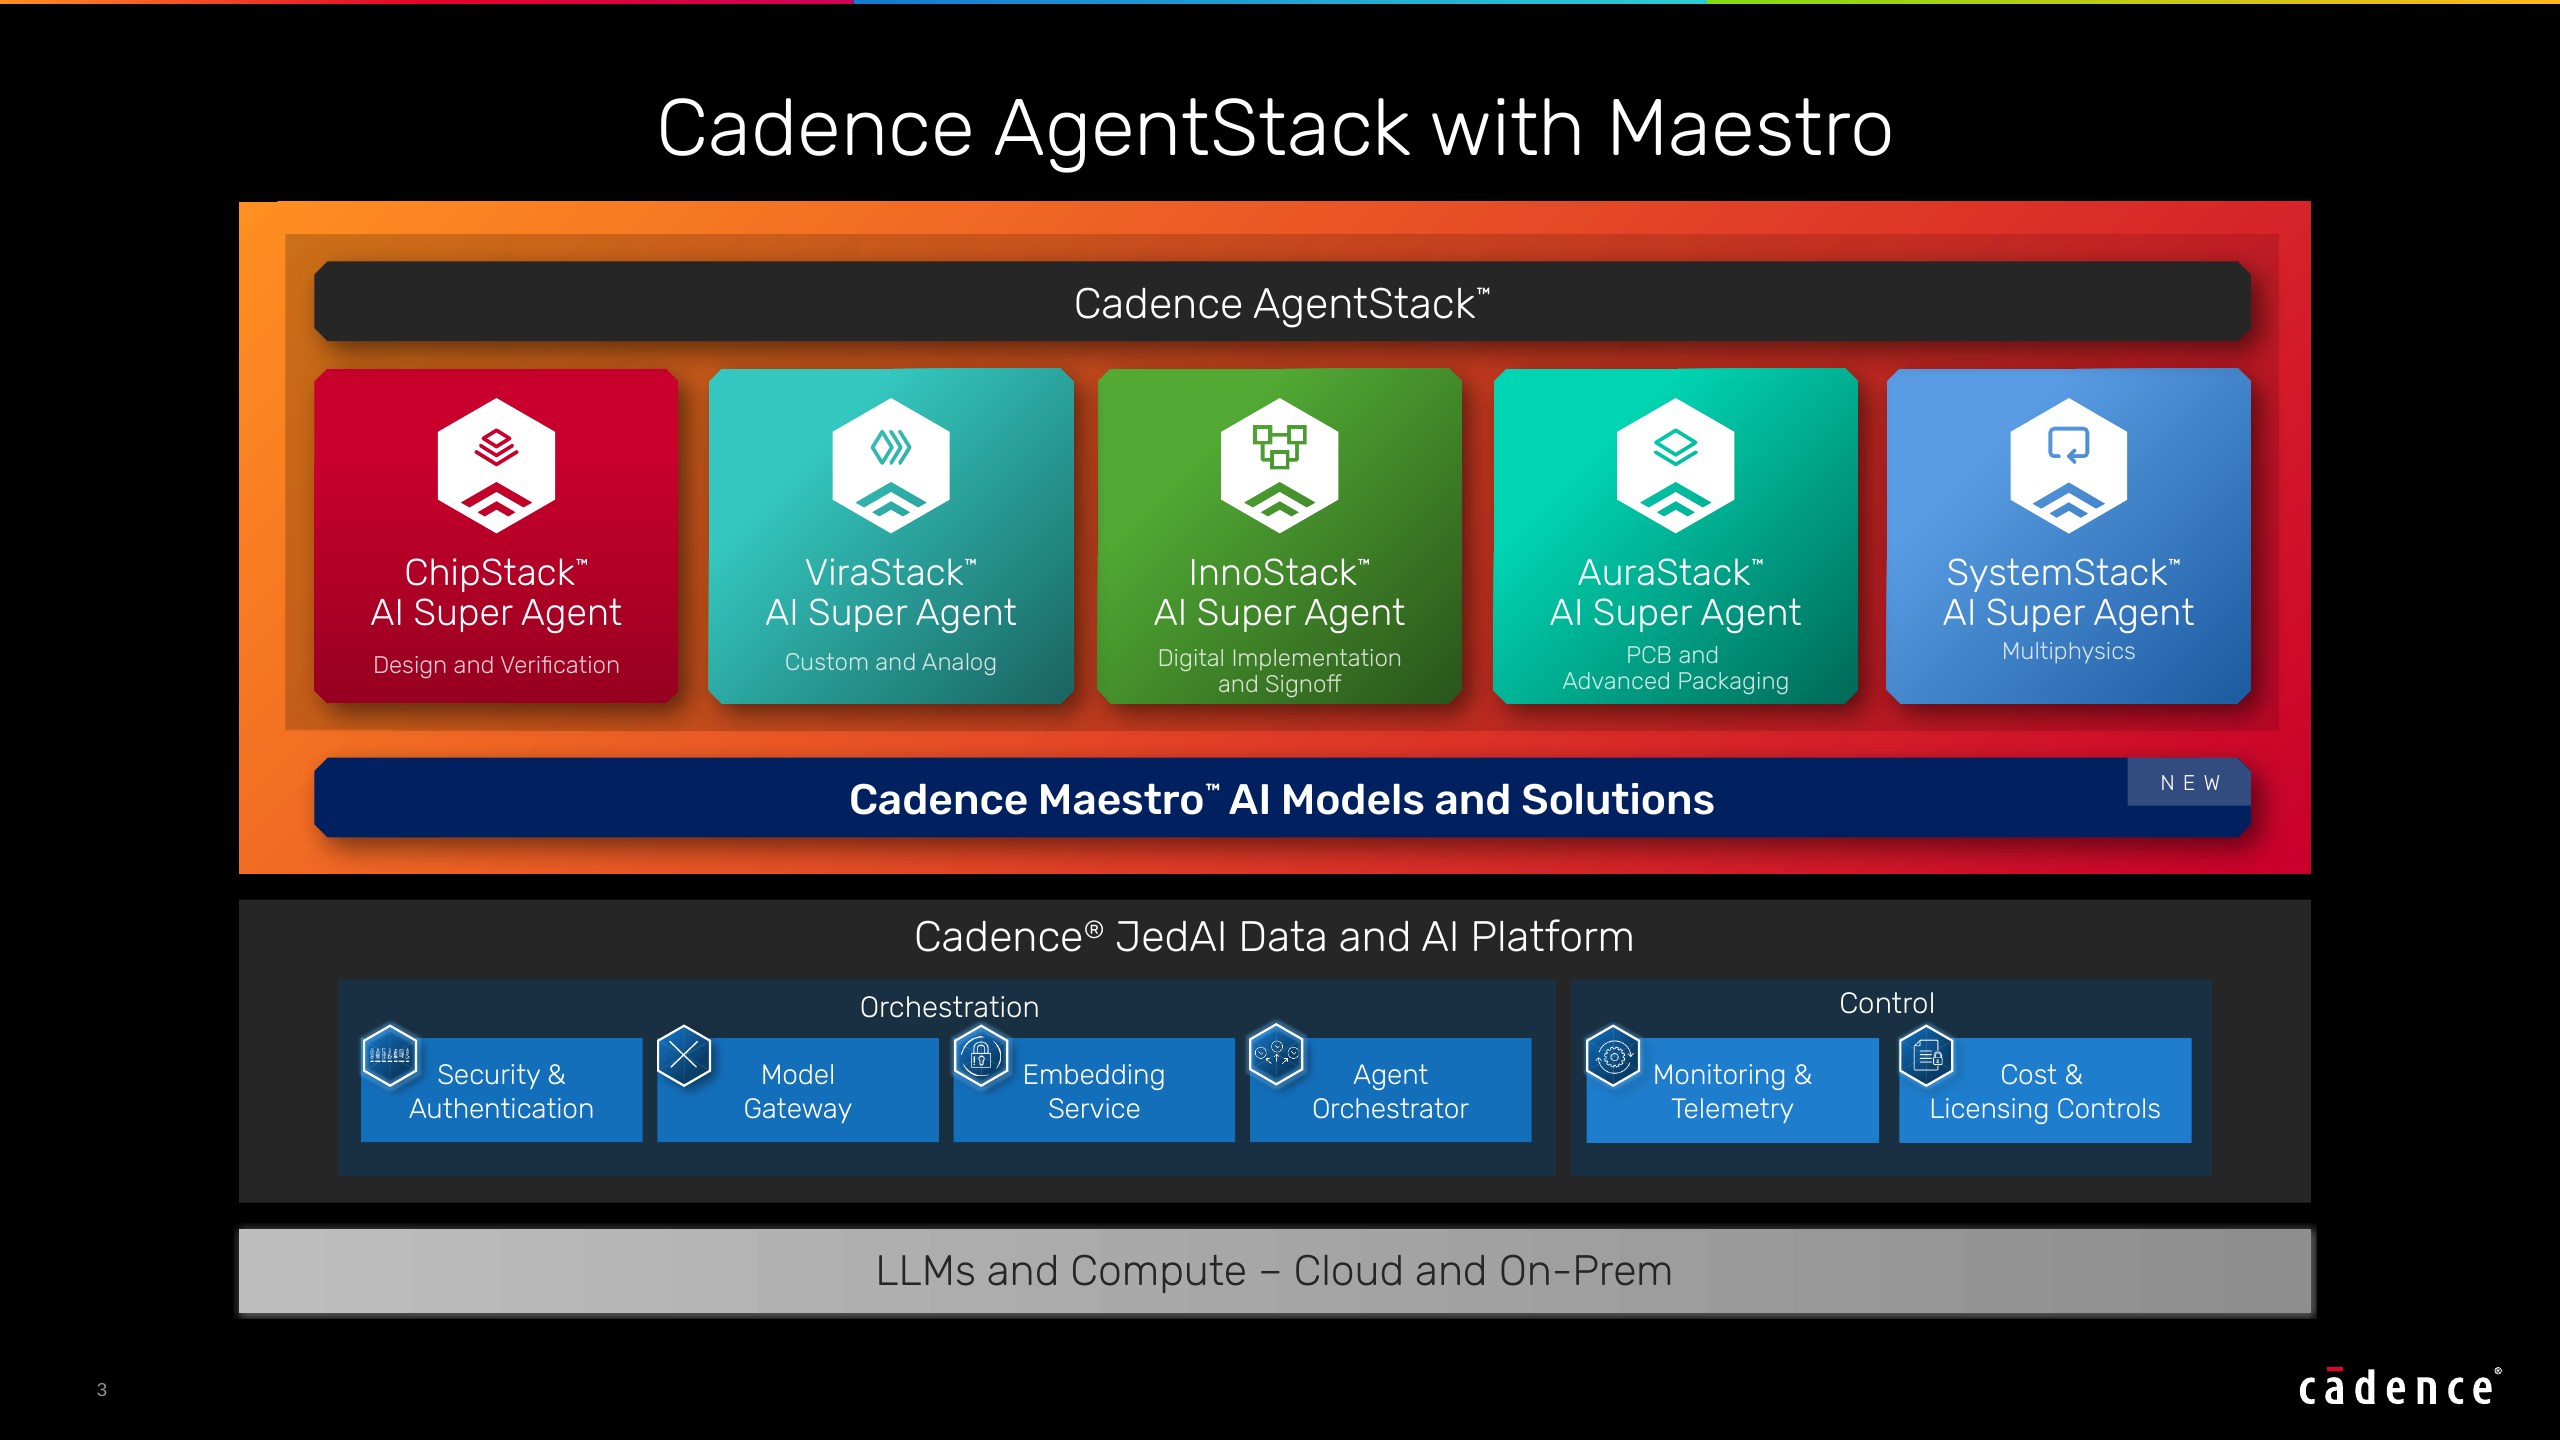
Cadence 是全球三大 EDA(电子设计自动化)厂商之一。Maestro 不是单一模型,而是一组针对芯片设计任务微调过的领域专用模型,被嵌入到该公司已有的 AgentStack 代理框架中。AgentStack 之上运行着 5 个 AI 超级代理,分别覆盖从规格定义、架构探索到物理实现和验证的不同环节。
最新消息Maestro 模型层下方是 JedAI 数据与 AI 平台,负责统一管理芯片设计流程中产生的海量数据,并为模型提供训练和推理所需的计算资源。Cadence 在公告中指出:“Maestro 是专门运行芯片设计代理的微调 AI 模型。”这套分层架构让大模型第一次能稳定地在真实 IC 设计流程中担任“自动驾驶”式的助理,而非仅仅生成建议。
最新资讯性能对比:30% 质量提升与 5 倍 Token 效率如何落地?
Cadence 给出了两项关键指标。第一是结果质量:在内部基准测试中,Maestro 相比通用大模型可将设计结果质量提升最多 30%;第二是 Token 效率:完成同样的任务,Maestro 消耗的 Token 仅为通用模型的五分之一,相当于 5 倍效率提升,也就是最多节省 80% 的算力成本。
突发事件这种提升来自领域微调。通用大模型需要先理解“什么是时序收敛”“什么是布线拥塞”,而 Maestro 在预训练阶段就注入芯片设计领域知识,因此推理时不需要在上下文中铺大量背景信息。Cadence 官方新闻稿也证实,客户可以在本地运行模型,并根据自身设计数据进行后训练。
| 对比项 | Maestro 专用模型 | 通用大模型 |
|---|
| --- | --- | --- |
|---|
| 设计质量 | 最高提升 30% | 基线水平 |
|---|
| Token 消耗 | 约为通用模型的 20% | 基线水平 |
|---|
| 效率倍数 | 最高 5 倍 | 1 倍 |
|---|
| 部署环境 | 本地或云端 | 通常仅云端 |
|---|
| 数据后训练 | 支持自有设计数据 | 通常不支持 |
|---|
本地部署与后训练:芯片设计数据安全成核心卖点
对于芯片公司来说,设计数据是最敏感的资产。Cadence 强调,Maestro 支持完整本地部署,客户可以在自己的数据中心运行模型。该公司官方材料中写道:“客户可以在本地运行这些模型,并利用自有设计和数据对模型进行后训练。”
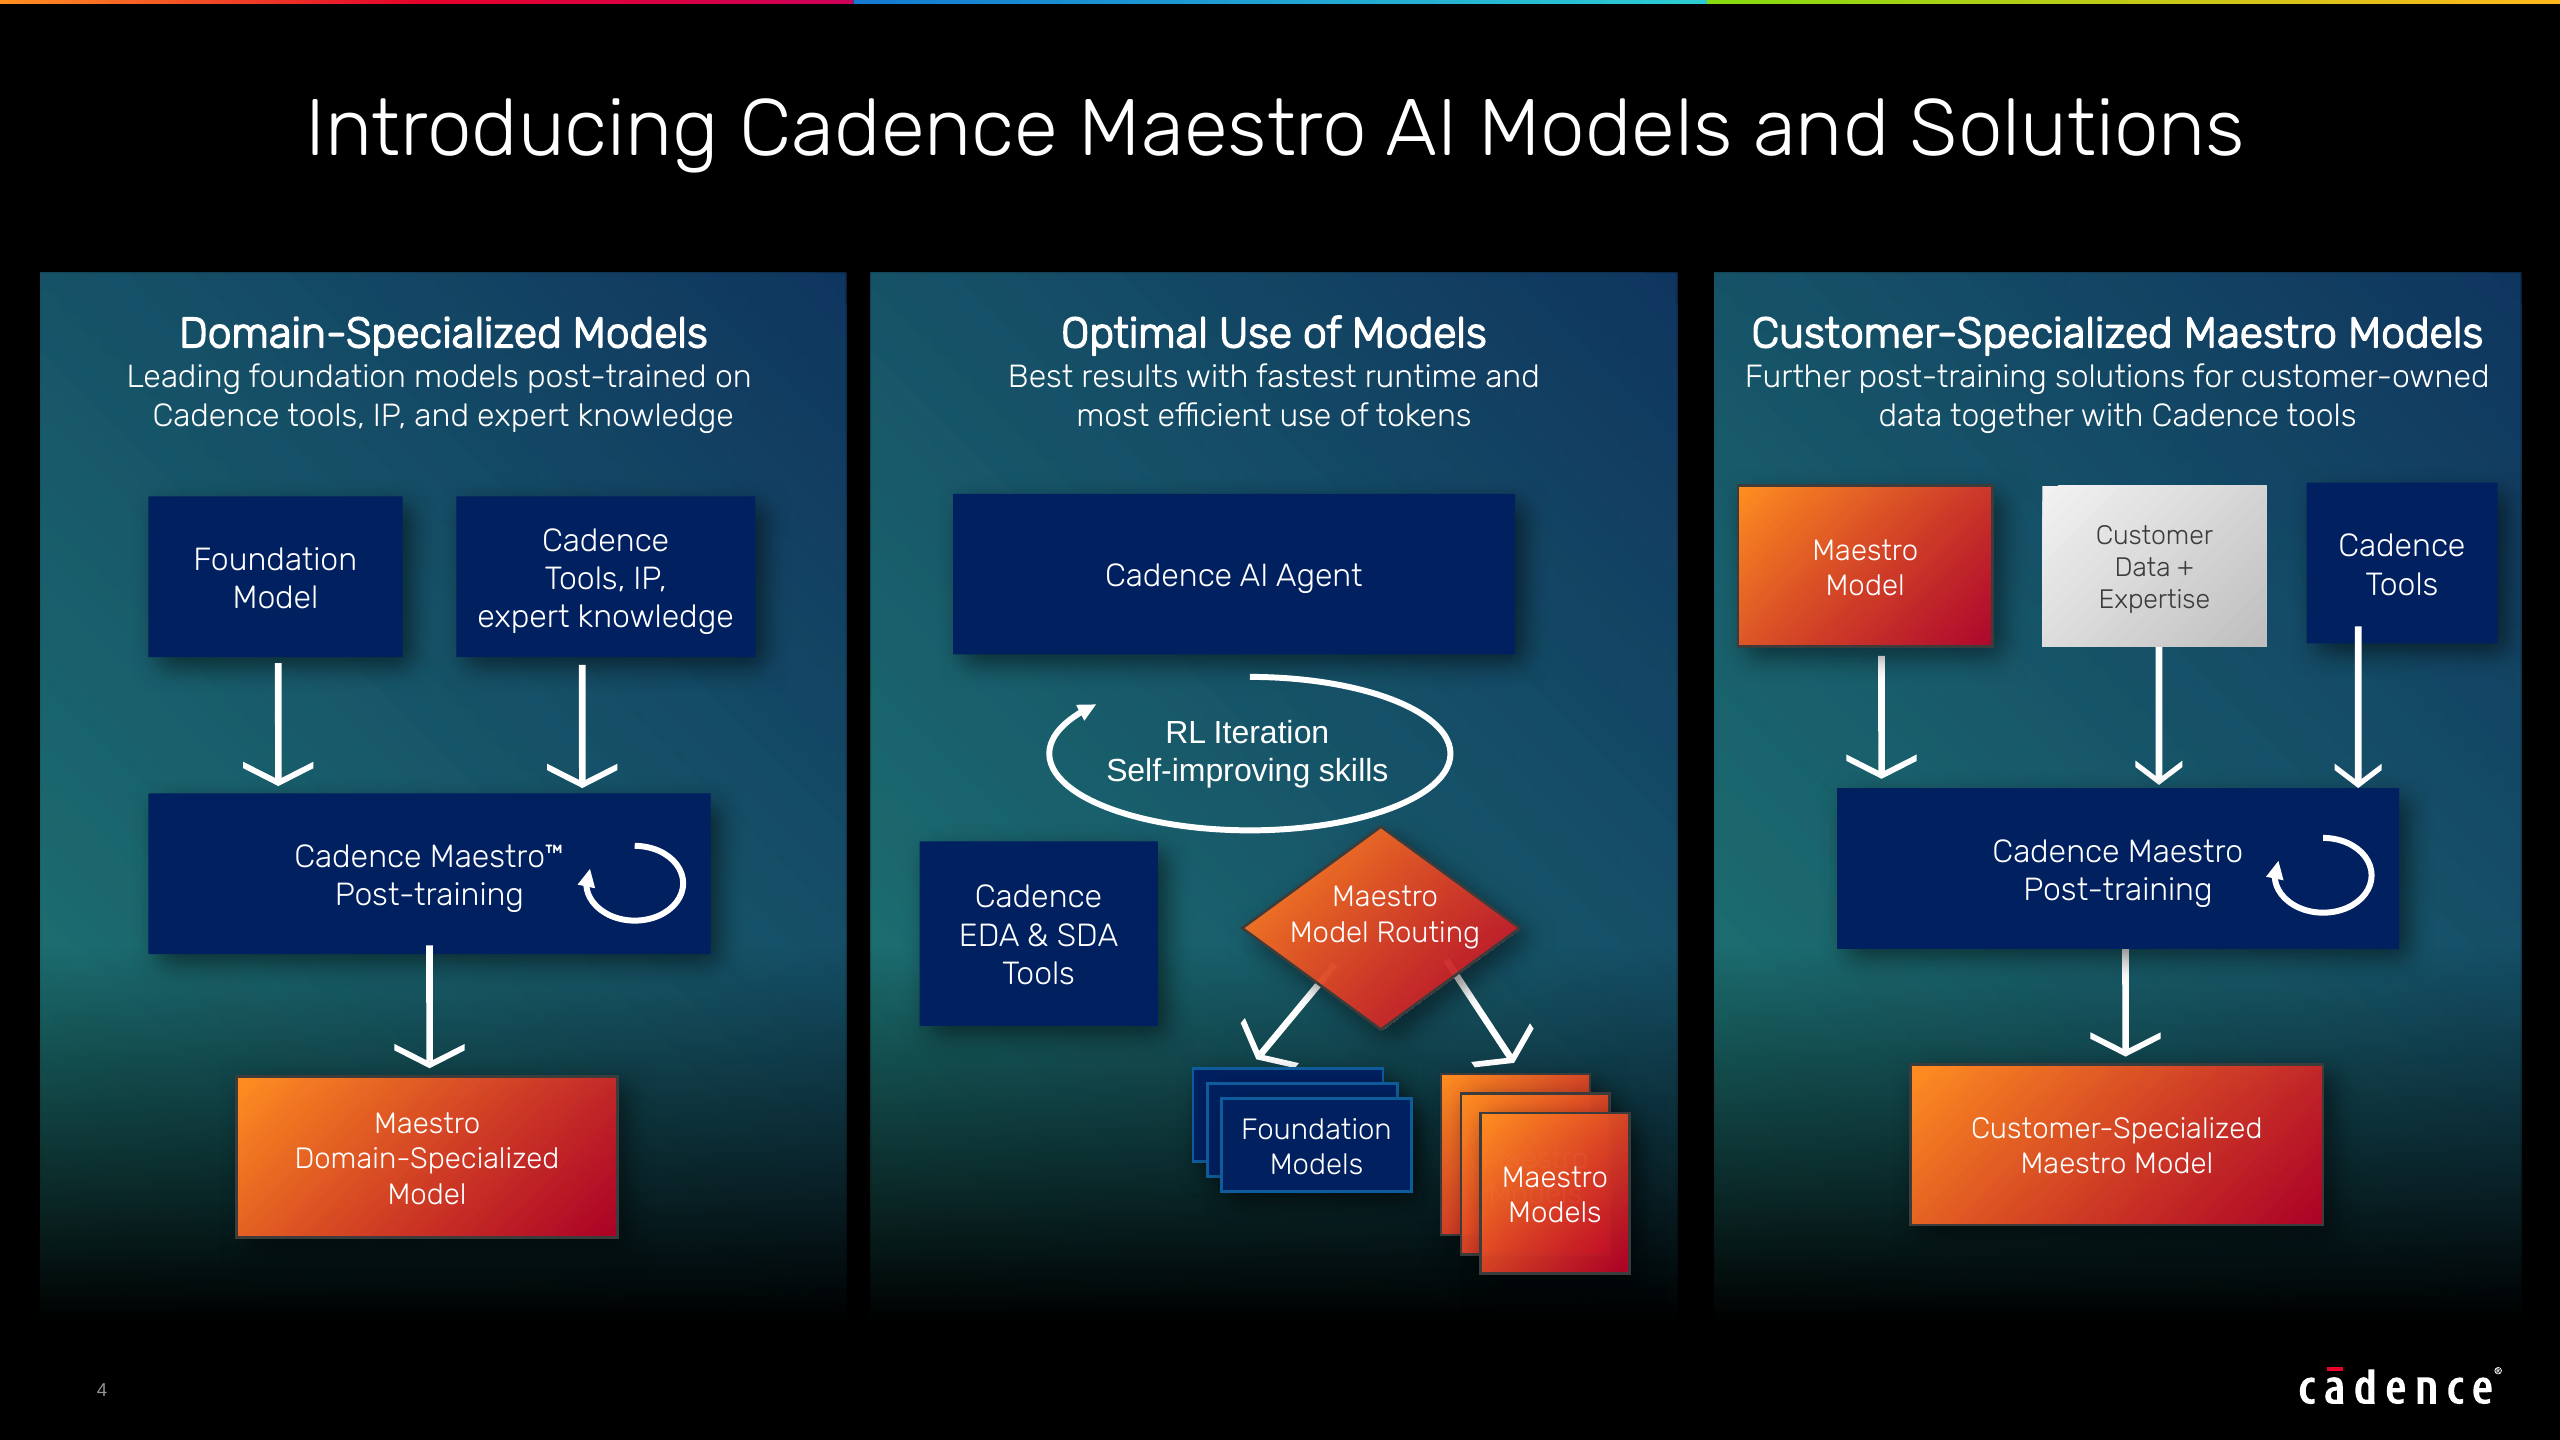
这意味着芯片厂商无需把寄存器传输级代码、版图文件或功耗数据上传给第三方云服务商。Cadence 表示,后训练过程可以由客户内部的 EDA 团队自行完成,也可以由 Cadence 协助开展,以便模型逐步适应某家公司特定的设计风格和工艺节点。
从 AgentStack 到 JedAI:Cadence 的 AI 平台战略
Maestro 的发布不是孤立动作。Cadence 正在把 AI 能力从辅助工具提升为系统级平台。AgentStack 负责编排代理,JedAI 负责提供数据和模型生命周期管理,Maestro 则是中间的“大脑”。这样一套组合的目标是让客户用更少的提示词和更少的错误迭代,完成复杂的芯片设计。
行业竞争也在加剧。Synopsys 与 Siemens EDA 同样在押注 AI,三巨头都在争夺“AI 原生设计流程”的早期红利。Cadence 选择先以专用模型加本地部署切入,正是希望用数据安全和可定制性留住高端客户。
时间表:2026 年第四季度开启早期访问
Maestro 的节奏相当明确。2026 年 10 月 26 日,Cadence 在发布材料中披露了相关细节;2026 年第四季度,公司将面向“精选客户”开放早期访问。参与早期计划的客户预计可以率先在本地环境中测试 Maestro 与 AgentStack 的集成效果。
Cadence 没有公布完整商用时间表,也没有公开 Maestro 的参数量或基础模型来源。根据 Cadence 官方材料与 Tom's Hardware 的报道,Maestro 会根据客户反馈持续迭代,未来可能扩展到更多芯片设计环节。
FAQ:Maestro 与通用大模型有何不同?客户如何获取?
Q1: Maestro 区别于通用大模型的核心在哪里?
A1: Maestro 是 Cadence 针对芯片设计场景微调的专用模型,内置 EDA 领域知识,设计结果质量最高提升 30%,Token 消耗仅为通用模型的五分之一,并且支持本地部署和自定义后训练。
Q2: 哪些客户能在 2026 年第四季度用上 Maestro?
A2: 早期访问面向 Cadence 的“精选客户”,主要是在尺寸、工艺和设计流程上有特定需求的芯片设计公司。Cadence 会根据客户的实际设计环境评估后定向邀请,尚未开放公开注册。
从 2026 年 10 月 26 日发布到第四季度早期访问,Cadence Maestro 专用 AI 模型正在把代理式 AI 真正拉进芯片设计的主流程。对于希望兼顾设计质量、算力成本与数据安全的芯片厂商来说,Maestro 提供了一条可落地的路径;而它能否复制到更多设计环节,将决定 EDA 智能化竞争的下一阶段走向。
留学资讯
2026年10月26日,Cadence 推出 Maestro 专用 AI 模型,为芯片设计代理提供领域微调能力。相比通用大模型,设计质量最高提升30%,Token 效率达5倍,支持本地部署与后训练,Q4 2026 向精选客户开放早期访问。本文详解技术架构、性能对比与获取方式,内容基于 Tom's Hardware 与官