XCENA MX1 CXL 计算存储 O... - 多人游戏
圣何塞时间2026年10月14日,OCP 全球峰会开幕。据 StorageReview 记者 Harold Fritts 现场报道,XCENA MX1 CXL 计算存储首次公开演示跨推理服务器共享 KV 缓存,并在内存内执行 RAG 向量搜索。SK hynix 同期推出基于 MX1 的 CXL 混合内存产品,两家公司已启动 RDMA 共享内存路径的联合优化。
花边趣闻MX1 技术底座:首个 CXL 3.2 计算存储控制器
据 StorageReview 报道,XCENA MX1 CXL 计算存储的核心是一颗 CXL 3.2 Type 3 内存控制器,这也是 XCENA 宣称的业内首款 CXL 3.2 计算存储芯片。该控制器提供 PCIe 6.0 双 x8 接口,支持每通道两条 256GB DIMM,单设备最大可配置 2TB DRAM。与单纯做容量扩展的 CMM-D 模块不同,MX1 内部搭载数千个定制 RISC-V 核心,配备 FP32 与 FP16 向量引擎,可在数据所在的内存侧执行推理辅助计算。控制器还集成独立的 PCIe 6.0 root complex,可直连 SSD 扩展容量,这一能力被命名为 InfiniteMemory。SK hynix 的混合内存产品,正是基于这套 DRAM 加 SSD 统一编址的架构构建。
花边八卦共享 KV 缓存:推理服务器如何摆脱重复数据
在第一个演示中,多台推理服务器通过 CXL 内存池共享同一份 KV 缓存。KV 缓存保存模型已处理的上下文 token,生成阶段可反复复用。传统方案下,每台服务器各自维护副本,造成内存浪费与跨节点数据同步开销。XCENA 将缓存集中于共享池,服务器通过 CXL 协议直接访问,副本数量从 N 份降为 1 份。据 StorageReview 观察,这与三星电子联手 AMD 在同期展示的 CMM-D 内存池方案逻辑一致;而在该缓存之下的闪存分层,该媒体此前已通过 KV 缓存卸载测试进行评估。XCENA 未公布此次演示的吞吐与延迟数据,仅确认现场使用多台标准推理服务器完成验证。
花边爆料向量搜索下沉到内存:RAG 管线的关键一步
第二个演示聚焦检索增强生成(RAG)中的向量搜索环节。MX1 借助近数据处理能力,直接在向量数据所在的 DRAM 内执行相似度检索,避免每次查询将海量向量集迁移至主机 CPU 或 GPU。XCENA 称,这种方式可显著降低 RAG 管线中的数据搬运开销,但截至 2026 年 10 月 16 日发稿,该公司仍未公布容量、QPS 或延迟等量化指标。首席产品官 Harry Kim 在峰会演讲中介绍了通用并行编程模型进入近数据处理领域的进展,强调开发者需要标准化的内存侧编程接口,才能充分调用这类计算存储硬件的算力。
明星趣闻SK hynix CXL 混合内存:DRAM 与 SSD 的容量折中
SK hynix 在 OCP 2026 展台推出的 CXL Hybrid Memory,核心组件正是 MX1 控制器。该产品通过 InfiniteMemory 将 DRAM 与 SSD 容量统一编址,形成新的存储层级。两家公司声称,这一架构的容量扩展能力远超传统 CMM-D DRAM 模块,而性能又显著优于直接访问 SSD。据 SK hynix 现场技术人员介绍,产品已完成实验室验证,正投入真实 AI 服务负载测试。双方合作的重点是基于 RDMA 的共享内存路径,这也是 OCP 可组合内存系统子项目正在标准化的方向。另据 SK hynix 在 FMS 2026 期间的公开演示,该公司当时已提出分层内存方案,本次发布可视为该路线在 CXL 生态中的商业化落地。
明星糗事OCP 2026 议程:XCENA 高管的两天密集日程
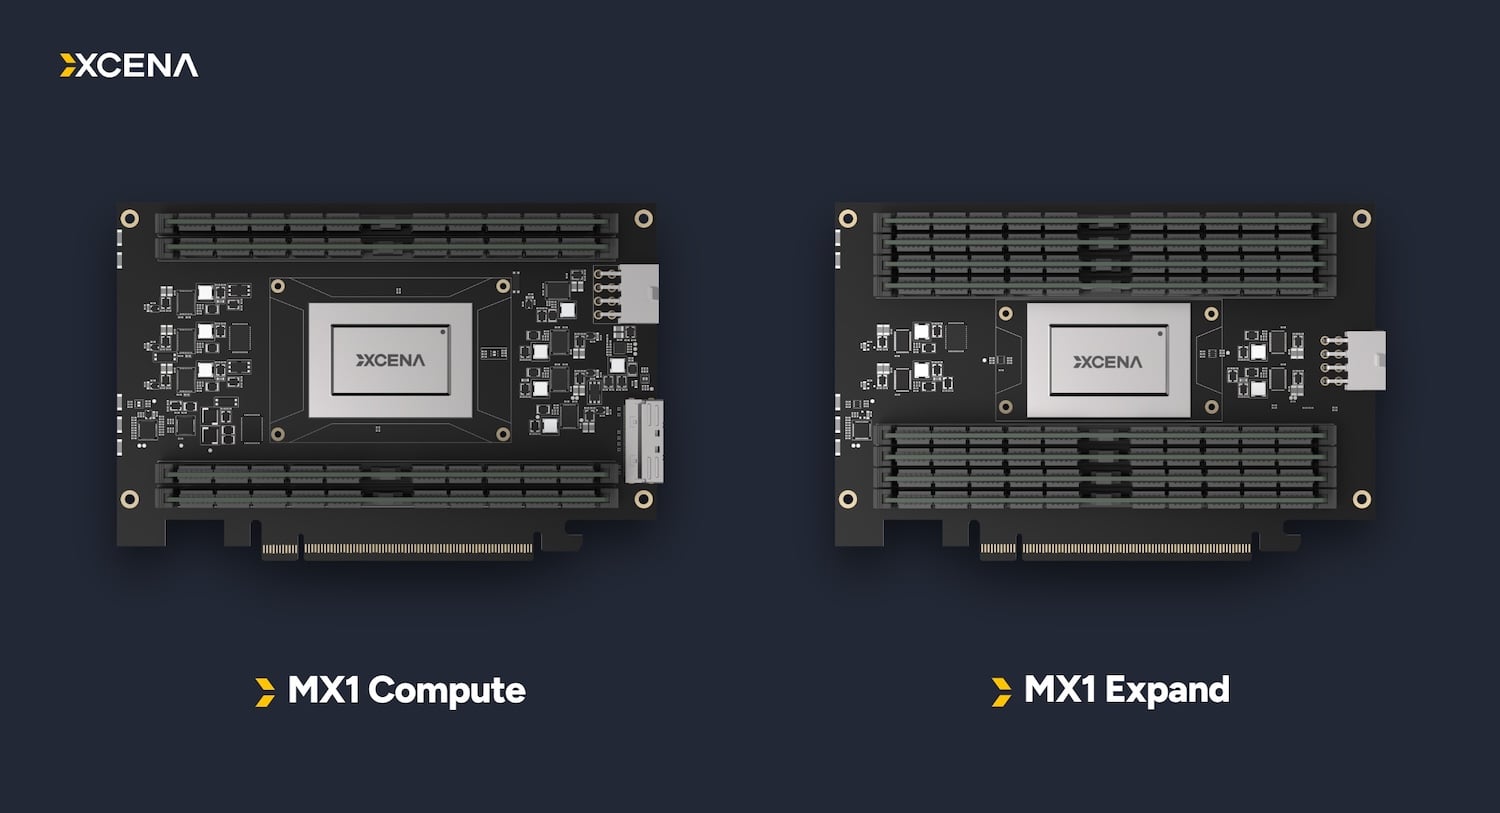
10 月 14 日,XCENA 首席产品官 Harry Kim 发表题为《为近数据处理引入通用并行编程》的演讲,并与 Marvell、三星、SK hynix 及 Gottbrath Technologies 代表同台,讨论异构 AI 基础设施的开放中间件。10 月 15 日,他与三星电子联合报告了面向代理式 AI 的分解式 CXL 内存研究,内容涵盖动态池化、内存共享与近内存卸载。同一天,该公司杰出工程师 Grant Mackey 与微软、希捷、Meta 的技术负责人共同参与 OCP 可组合内存系统子项目技术更新,专题讨论"内存墙"问题。从议程密度看,XCENA 正试图同时影响存储、网络与云服务商三条产品线。
融资与时间表:1.85 亿美元押注内存计算
XCENA 首席执行官 Jin Kim 在峰会期间表示:"提升 AI 基础设施的性能与效率,已不再仅仅是计算层面的挑战。"他补充:"它还取决于内存的使用效率,以及能否消除数据移动。"截至 2026 年 10 月,该公司累计融资 1.85 亿美元,其中 B 轮融资 1.35 亿美元。总部位于韩国城南市,美国办公室设在加州桑尼维尔。以下为此次 OCP 2026 发布的关键时间线:
| 关键节点 | 时间 | 内容 |
|---|
| --- | --- | --- |
|---|
| MX1 定位 | 2026年10月 | 首款 CXL 3.2 计算存储,PCIe 6.0 双 x8,支持 2TB DRAM |
|---|
| OCP 演示一 | 2026年10月14-15日 | 跨推理服务器共享 KV 缓存(CXL 内存池) |
|---|
| OCP 演示二 | 2026年10月14-15日 | 内存内 RAG 向量搜索 |
|---|
| SK hynix 发布 | 2026年10月 | 基于 MX1 的 CXL Hybrid Memory,联合优化 RDMA |
|---|
| 累计融资 | 截至2026年10月 | 1.85 亿美元,B 轮 1.35 亿美元 |
|---|
FAQ
Q1:XCENA MX1 如何实现 KV 缓存的跨服务器共享?
A1: MX1 作为 CXL 3.2 Type 3 内存设备,通过 CXL 内存池将多台推理服务器的 KV 缓存合并为共享副本,模型生成阶段可直接访问,避免每台服务器各自保存并同步。同时,MX1 的 RISC-V 近数据处理核心可在缓存所在地执行部分计算,减少主机间数据搬运。StorageReview 现场确认,三星 CMM-D 与 AMD 的联合演示采用类似技术路线。
Q2:SK hynix CXL 混合内存相比普通 CXL 内存模块有何优势?
A2: 普通 CMM-D 模块只有 DRAM,容量受内存颗粒数量限制;SK hynix 基于 MX1 的混合内存通过 InfiniteMemory 挂接 SSD,容量扩展上限更高,同时借由近数据处理维持优于 SSD 的性能。两家公司已将该方案投入真实 AI 服务环境验证,并优先优化 RDMA 共享内存路径,目标是成为介于内存与闪存之间的新层级。
从共享 KV 缓存到内存内向量搜索,XCENA MX1 CXL 计算存储正把计算推向数据所在之处。随着 SK hynix 混合内存进入验证,可组合内存市场有望在 2027 年迎来规模化部署。
秀恩爱照
XCENA MX1 CXL 计算存储在 OCP 2026 现场完成两项重磅演示:跨推理服务器共享 KV 缓存,内存内执行 RAG 向量搜索;SK hynix 同步推出基于 MX1 的 CXL 混合内存。本文详解 CXL 3.2 技术架构、近数据处理设计、RDMA 联合优化及 1.85 亿美元融资进展,并给出产品路线图展